今日从 arXiv 订阅中筛选 10 篇论文。
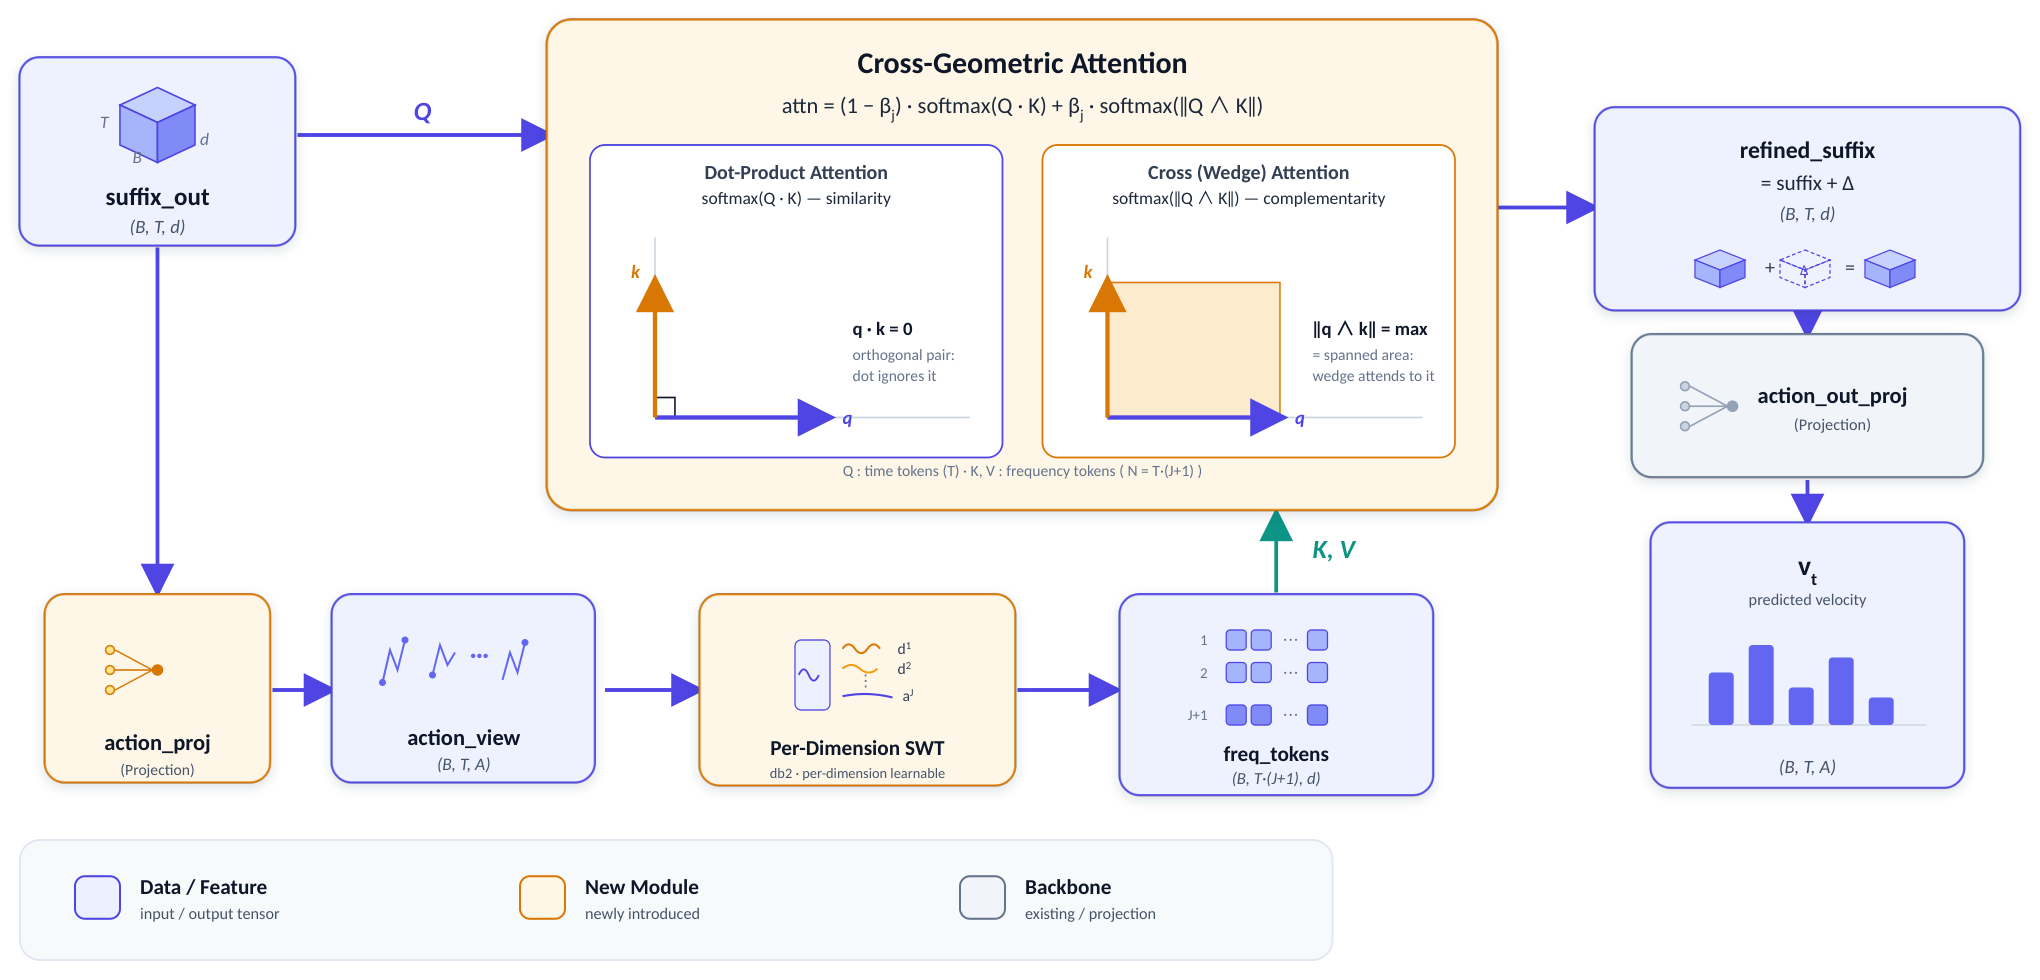
⚡ Time-Frequency Geometric Cross-Attention for Chunked Vision-Language-Action Models
动作 chunk 的表征补丁:时频分解+楔积注意力,对近正交相位敏感,零初始化 drop-in,真机 OOD 增益大于 ID。
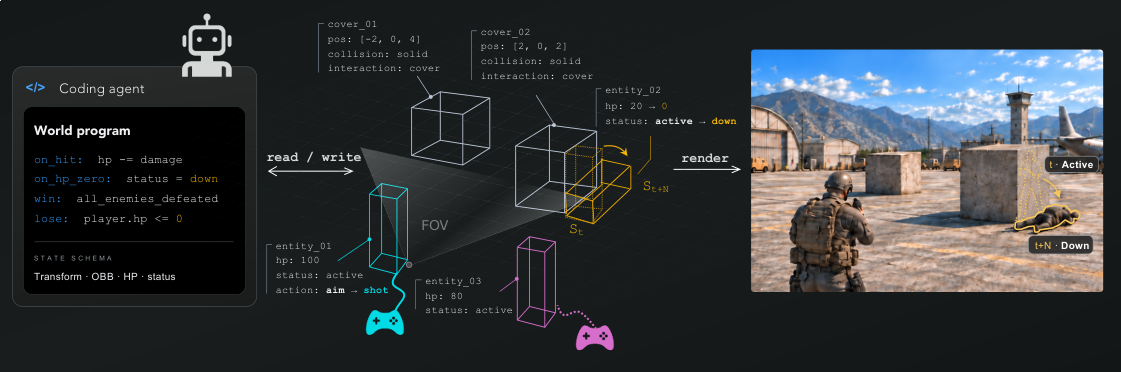
⚡ Programmable World Model
世界状态做成"可编程程序"显式维护:状态演化与渲染解耦,可暴力改离屏实体,CombatStateBench 94/98。
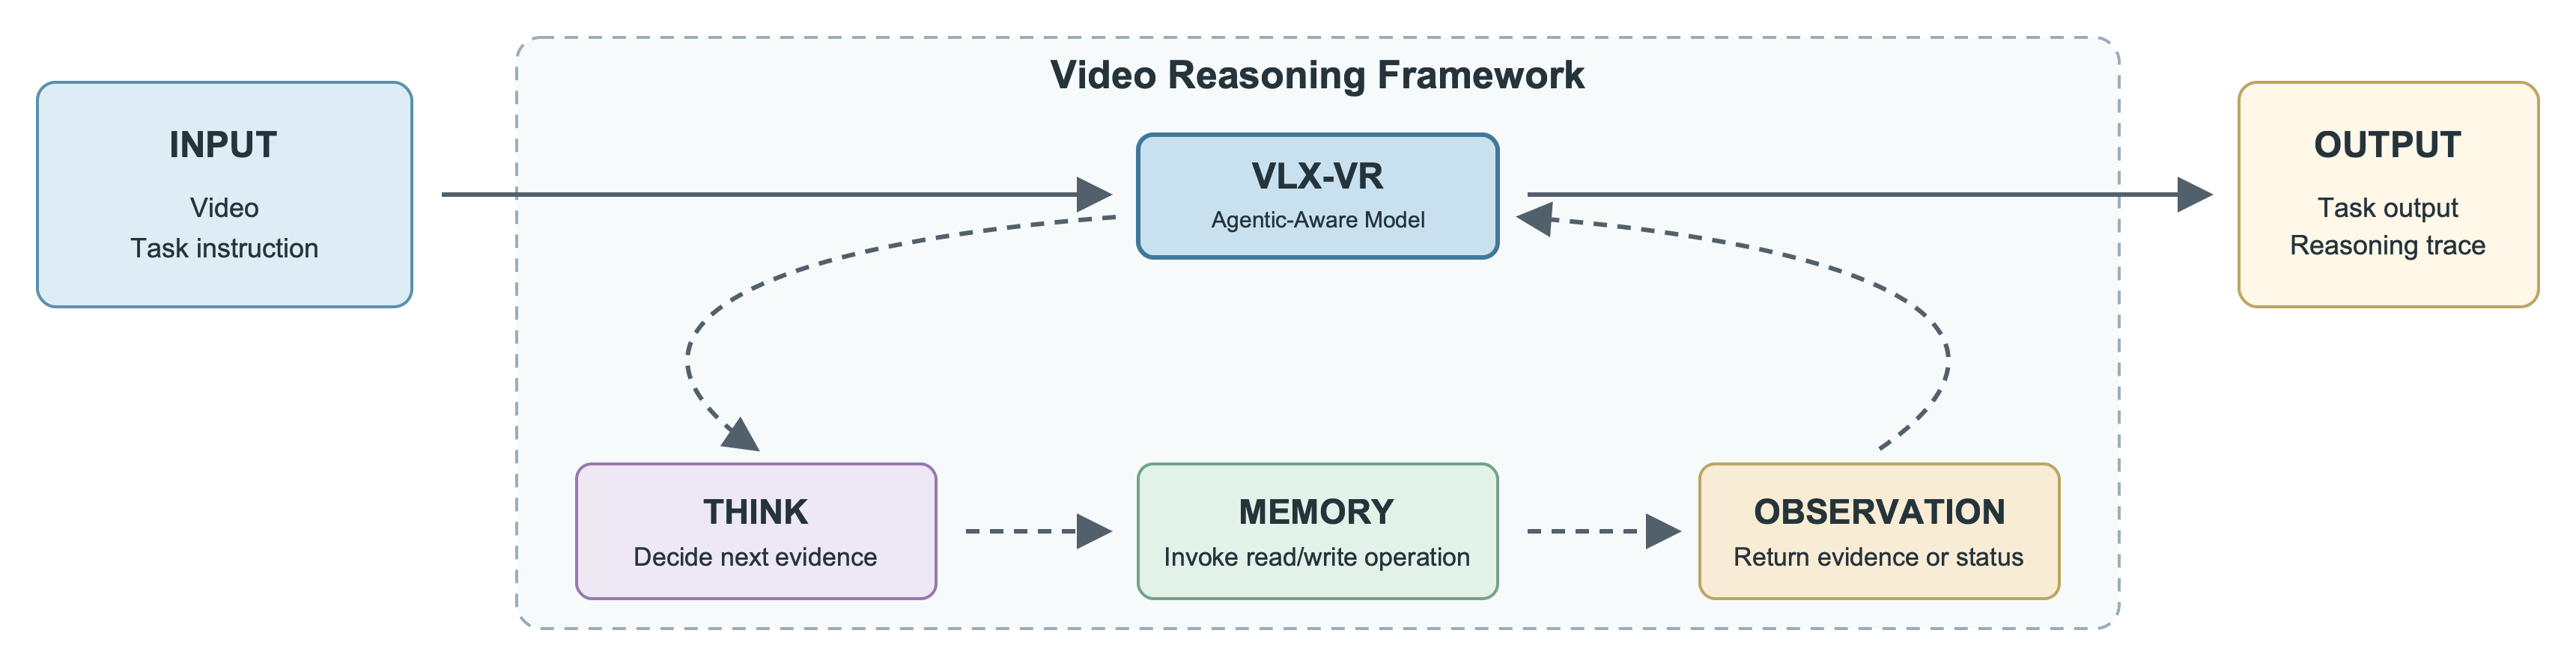
⚡ VLX-VR: An Agentic-Aware Video Reasoning Model
视频推理的 agentic 证据闭环:Think–Memory–Observation 循环 + RL,96.2% 推理轨迹与参考证据一致。
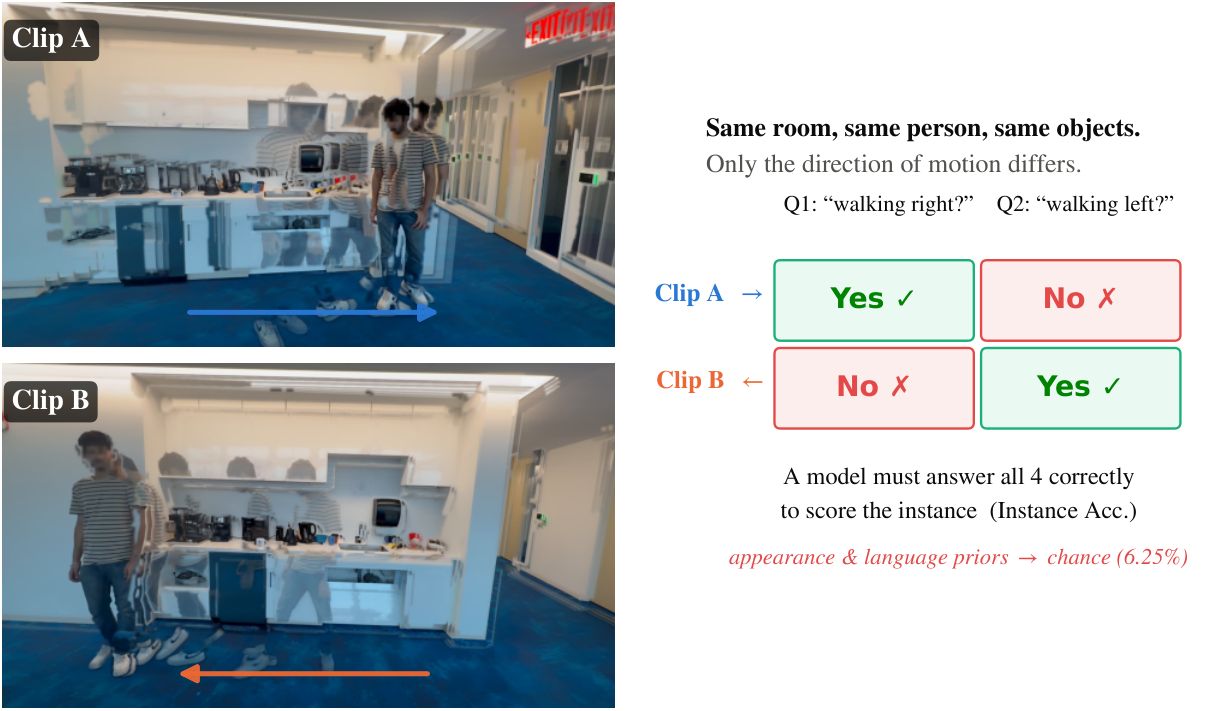
⚡ MotionBlind: Probing the Illusion of Motion Understanding in Video-LLMs
Video-LLM 运动理解幻觉的硬证据:开源全在 6.25% 随机线,删视频=0、打乱帧=随机,只有 Gemini3.1 Pro 过线且速度挂。
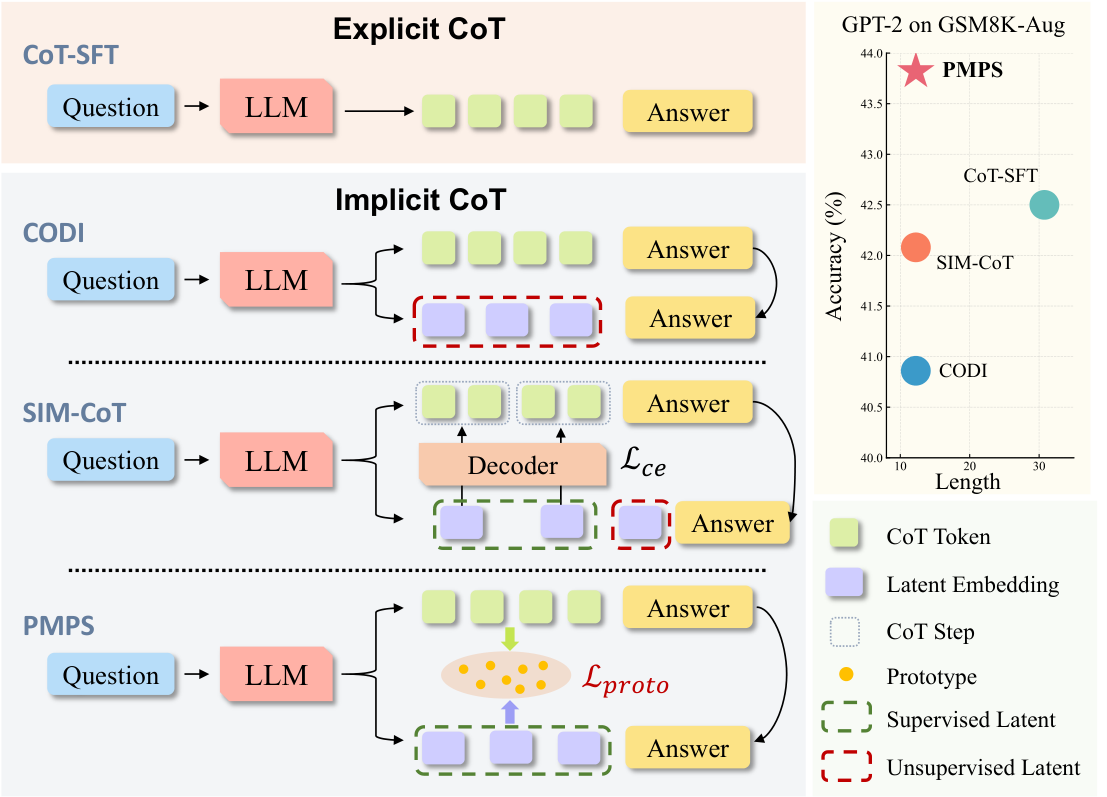
⚡ Structural Process Supervision for Latent Chain-of-Thought Reasoning
隐 CoT 的过程监督:原型锚做多对多软对齐防坍塌,token<50% 且比 SIM-CoT 平均 +2.08%。
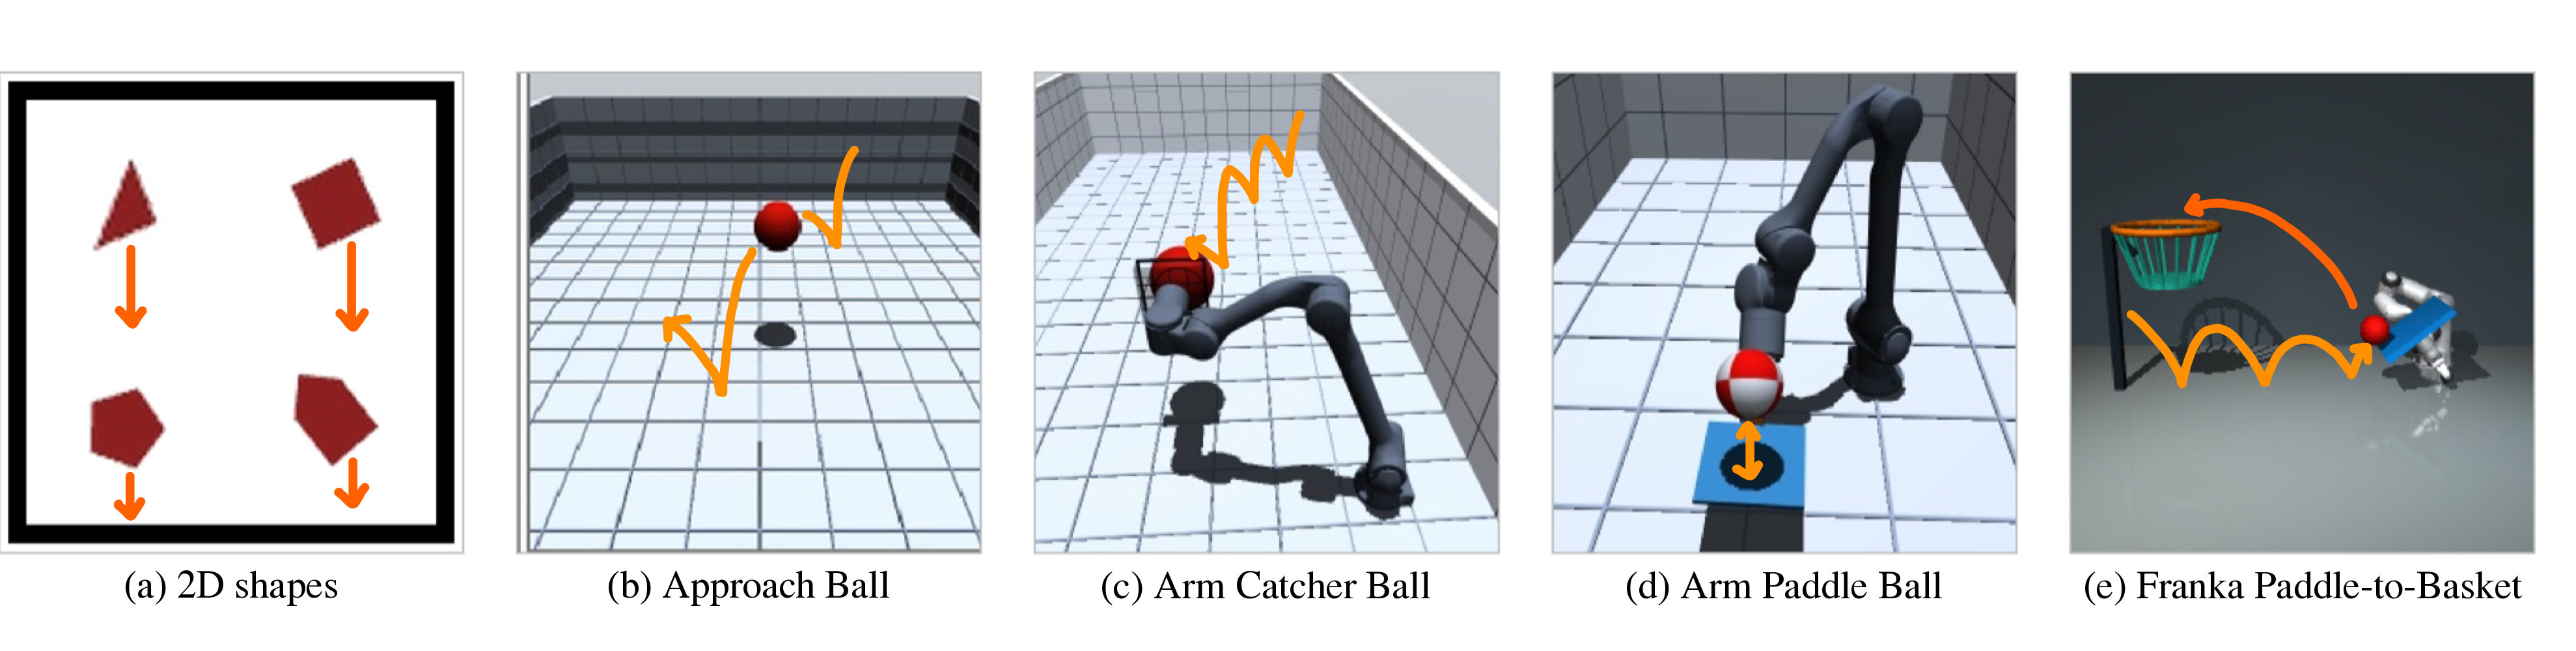
⚡ Semigroup-JEPA: Latent Dynamics Consistency for Zero-Shot Physics Generalization
物理参数进 JEPA:重力场 conditioning+latent rollout 联合训练;增益来自 encoder 学到"可携带"特征。
⚡ World-Time Compute with Verified Code World Models
可验证代码世界当数据制造机:0.5B +29 点、跨世界 +34 点,增益来自"标签精确性"而非多样性。
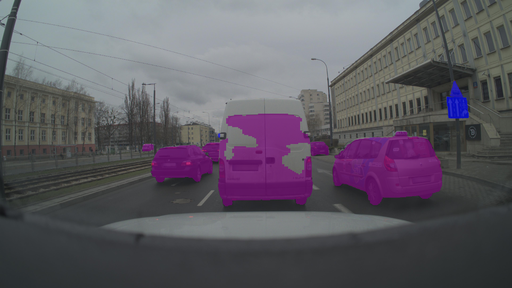
⚡ CLFTv2: Efficient Camera-LiDAR Fusion for Semantic Segmentation via Hierarchical Feature Pyramids
相机-LiDAR 融合效率向增量:Swin 多尺度+FPN 残差解码,ZOD 行人 IoU +9.4、比 Mask2Former 省 1.4× GFLOPs。
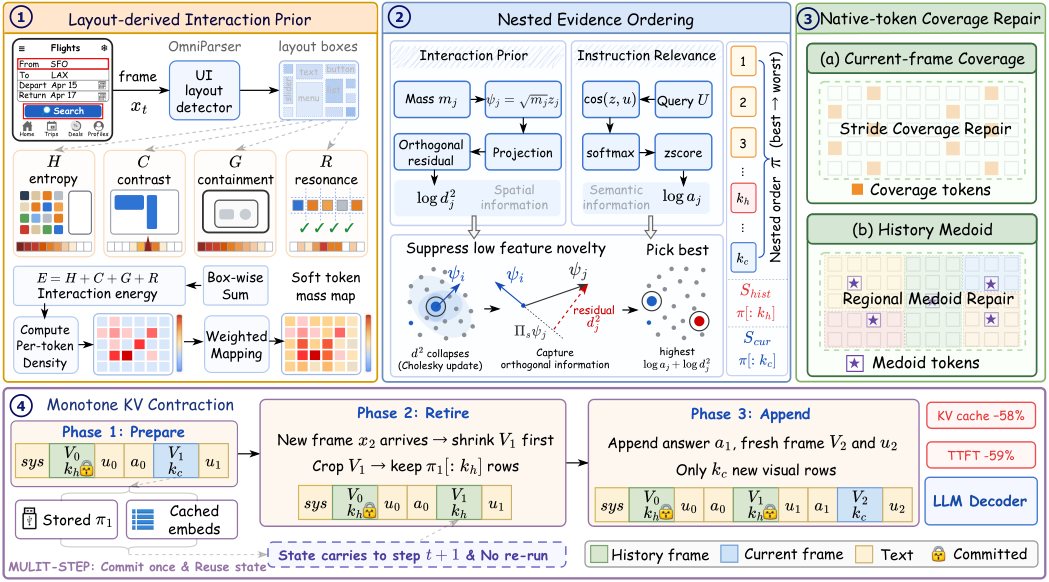
⚡ TRACE: Trajectory-robust Admission with Evidence Ordering for Efficient GUI Agents
剪枝=不可逆准入决策:布局先验+相关性+新颖度排序,预留覆盖修复,嵌套收缩全程可复用。
⚡ LogiScope-VQA: Benchmarking Vision-Language Models for Logistics Hazard Identification in Industrial Scenarios
工业仓库危险识别基准:10274 VQA、39 子任务;GPT-5.5/Gemini-3.1-Pro/Claude-Opus-4.7 全低于人类。
自动生成于 2026-09-11 · 基于 arXiv Daily Digest