今日从 arXiv 订阅中筛选 10 篇论文。
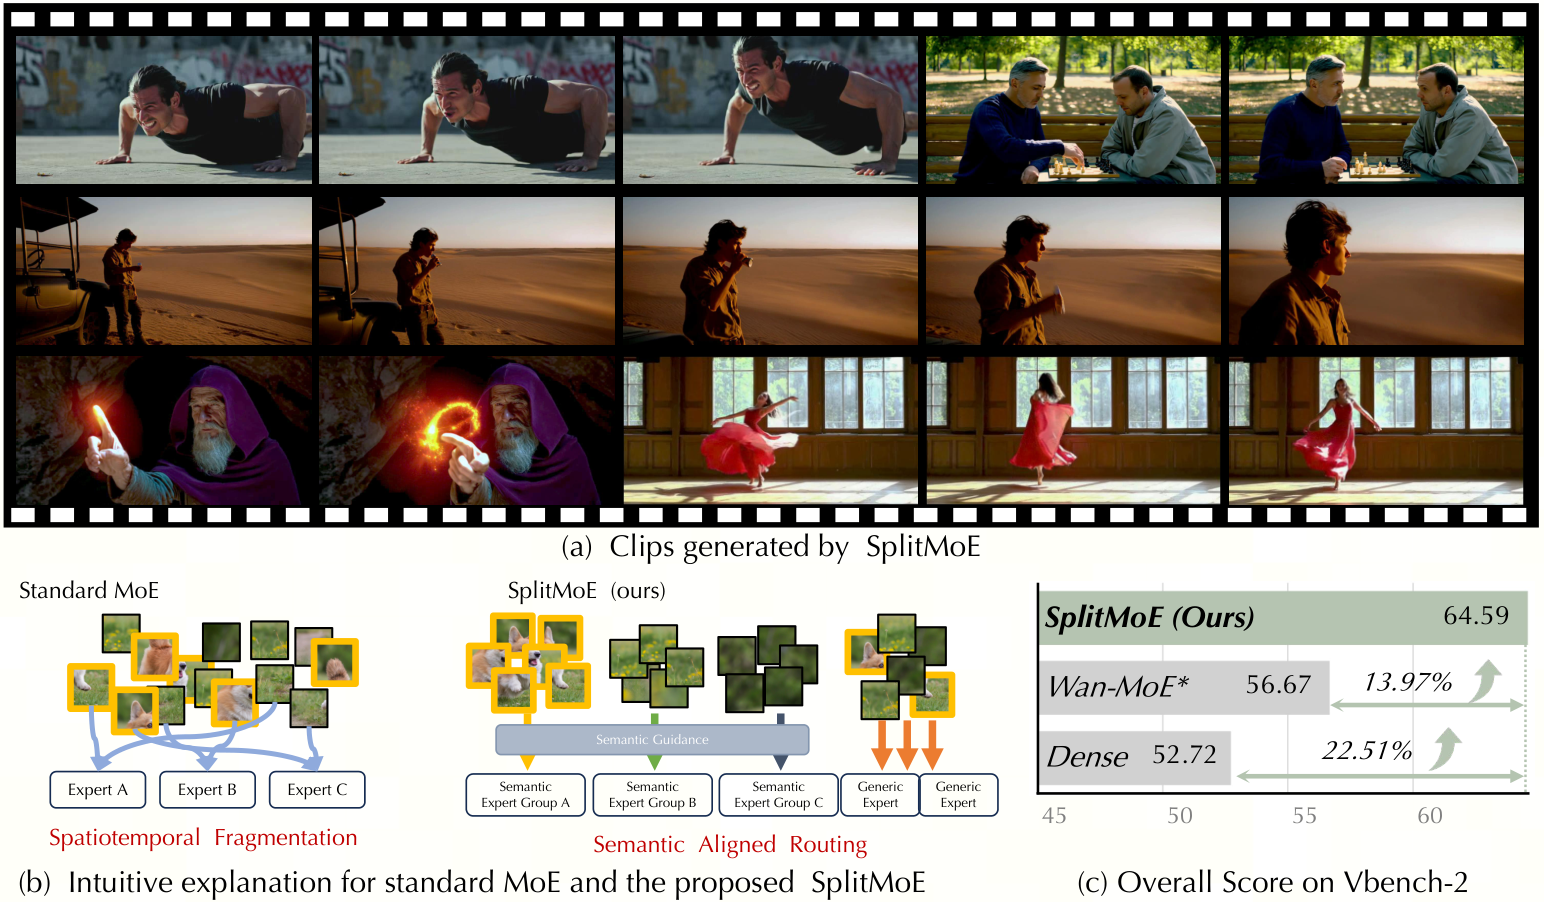
⚡ Breaking the Uniformity Trap: Scaling Video Diffusion Model via SplitMoE
视频扩散 MoE 的 uniformity trap:把专家池拆成两种角色。
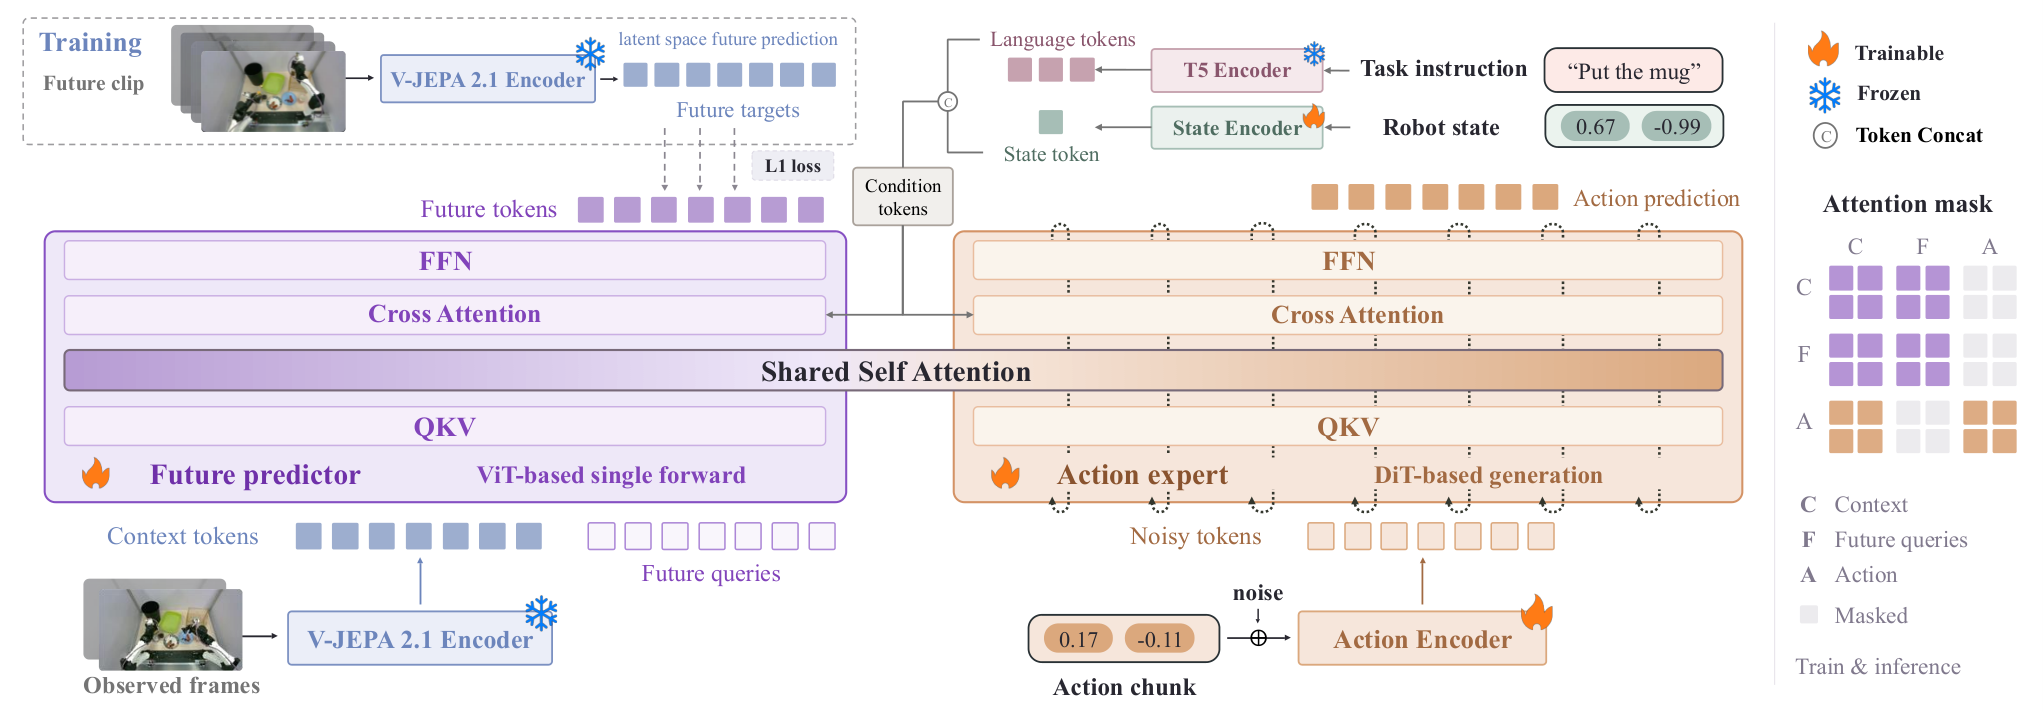
⚡ V-JEPA Policy: Building Effective World-Action Models on Predictive Visual Latents
WAM 底座之战:不继承生成器,预测式潜空间够不够?
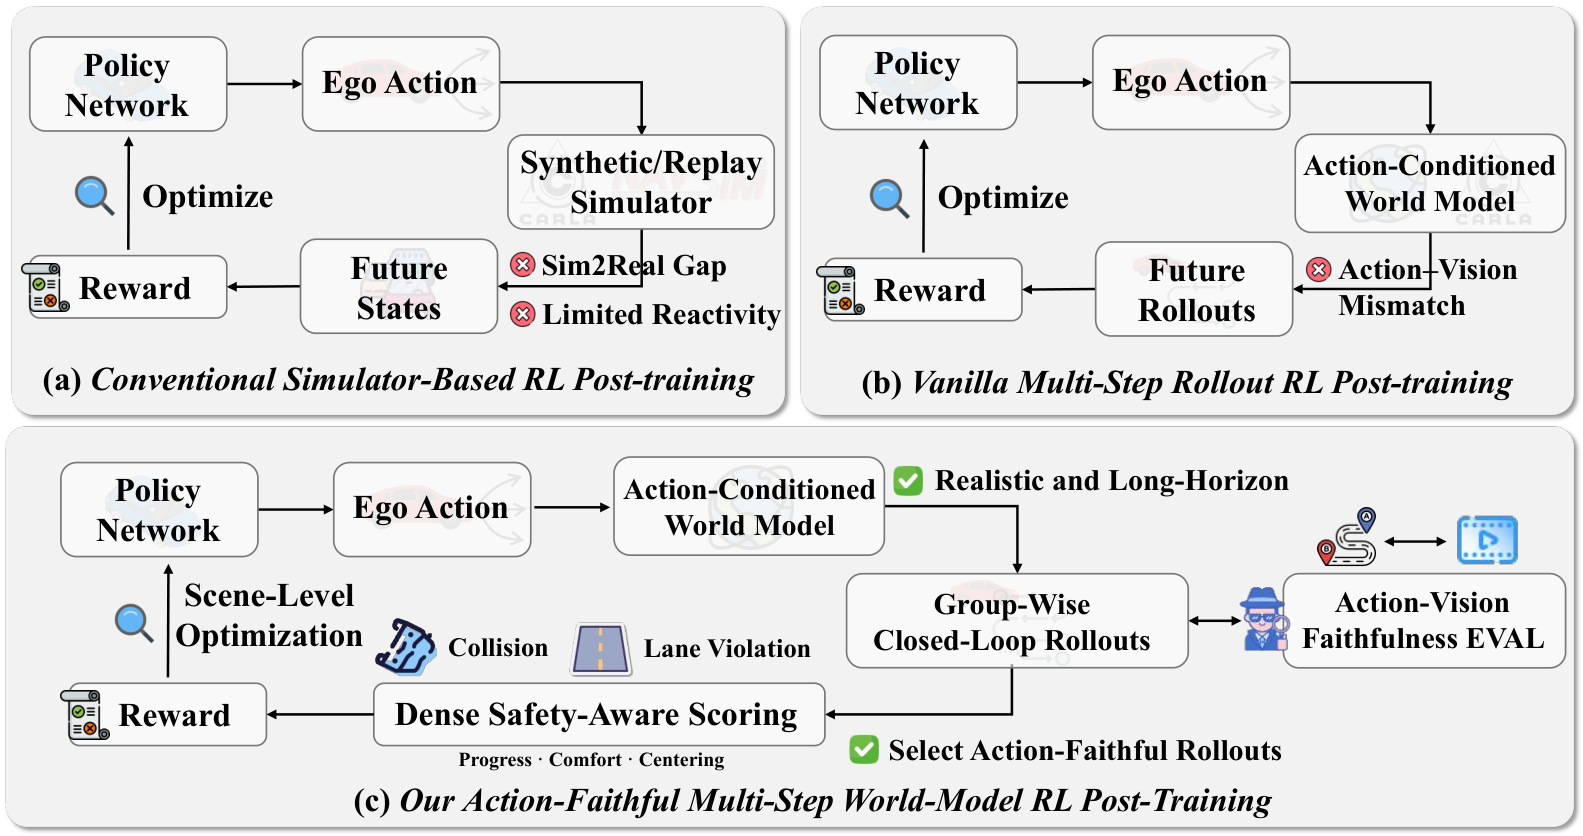
⚡ RoXDrive: Closed-Loop Reinforcement Learning for End-to-End Autonomous Driving via Action-Faithful Rollouts
世界模型当 RL 环境之前,先过「动作忠实性」滤网。
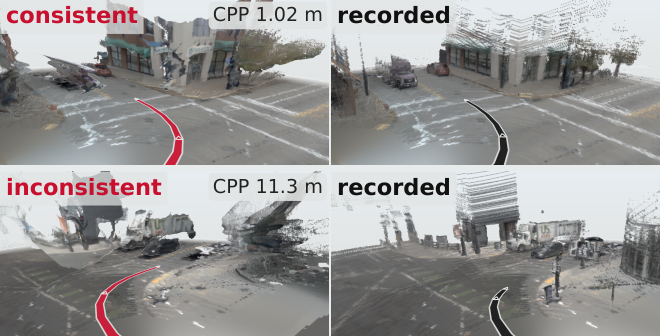
⚡ PhysWAM: Physically Consistent World Action Model for Autonomous Driving
用「深度×运动」的几何关系把世界与动作焊在一起。
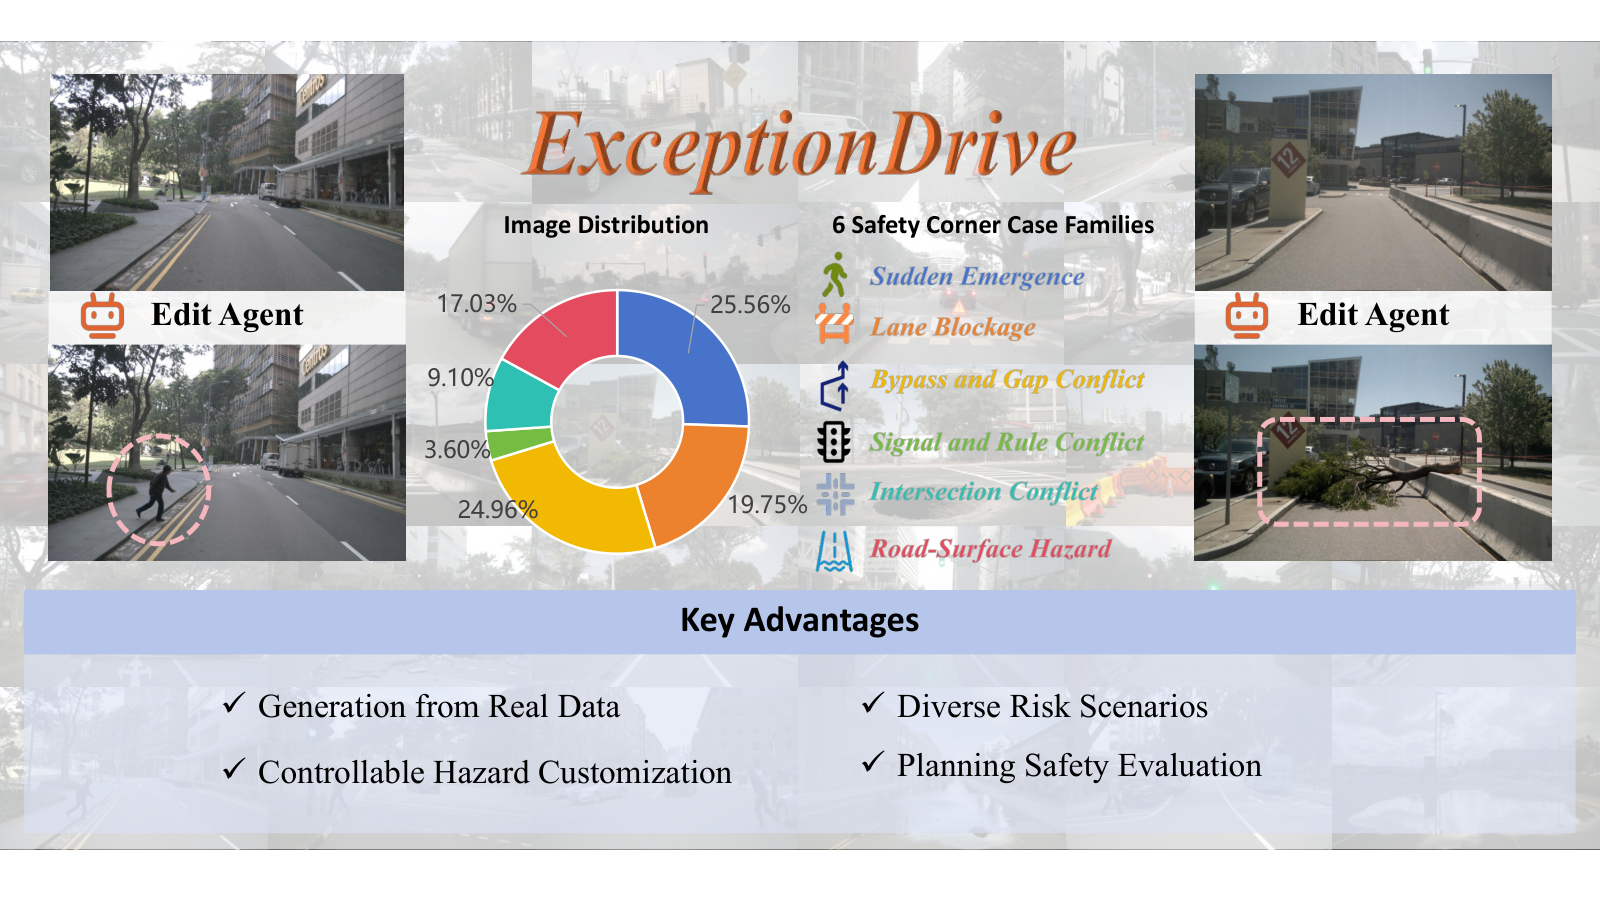
⚡ ExceptionDrive: A Planning-Oriented Counterfactual Corner-Case Benchmark for Autonomous Driving
平均分不测危险:把 hazard 注入真实场景再考规划器。
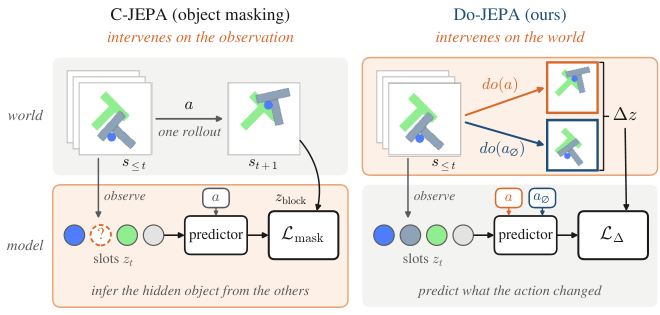
⚡ Do-JEPA: From Masking to Intervention in Latent World Models
干预物理世界,而不是模型能看见什么。
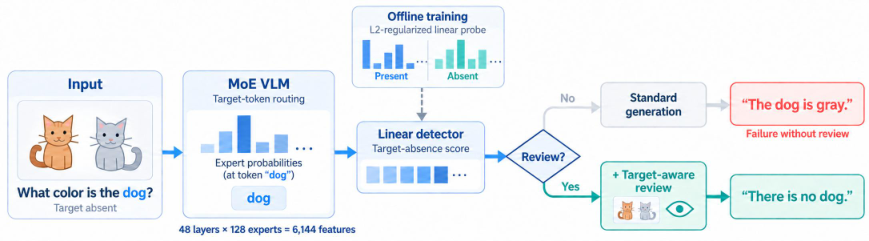
⚡ From Routing Signals to Selective Review: Visual regrounding in MoE VLMs
路由概率不只是负载表:它是随身的感知证据。
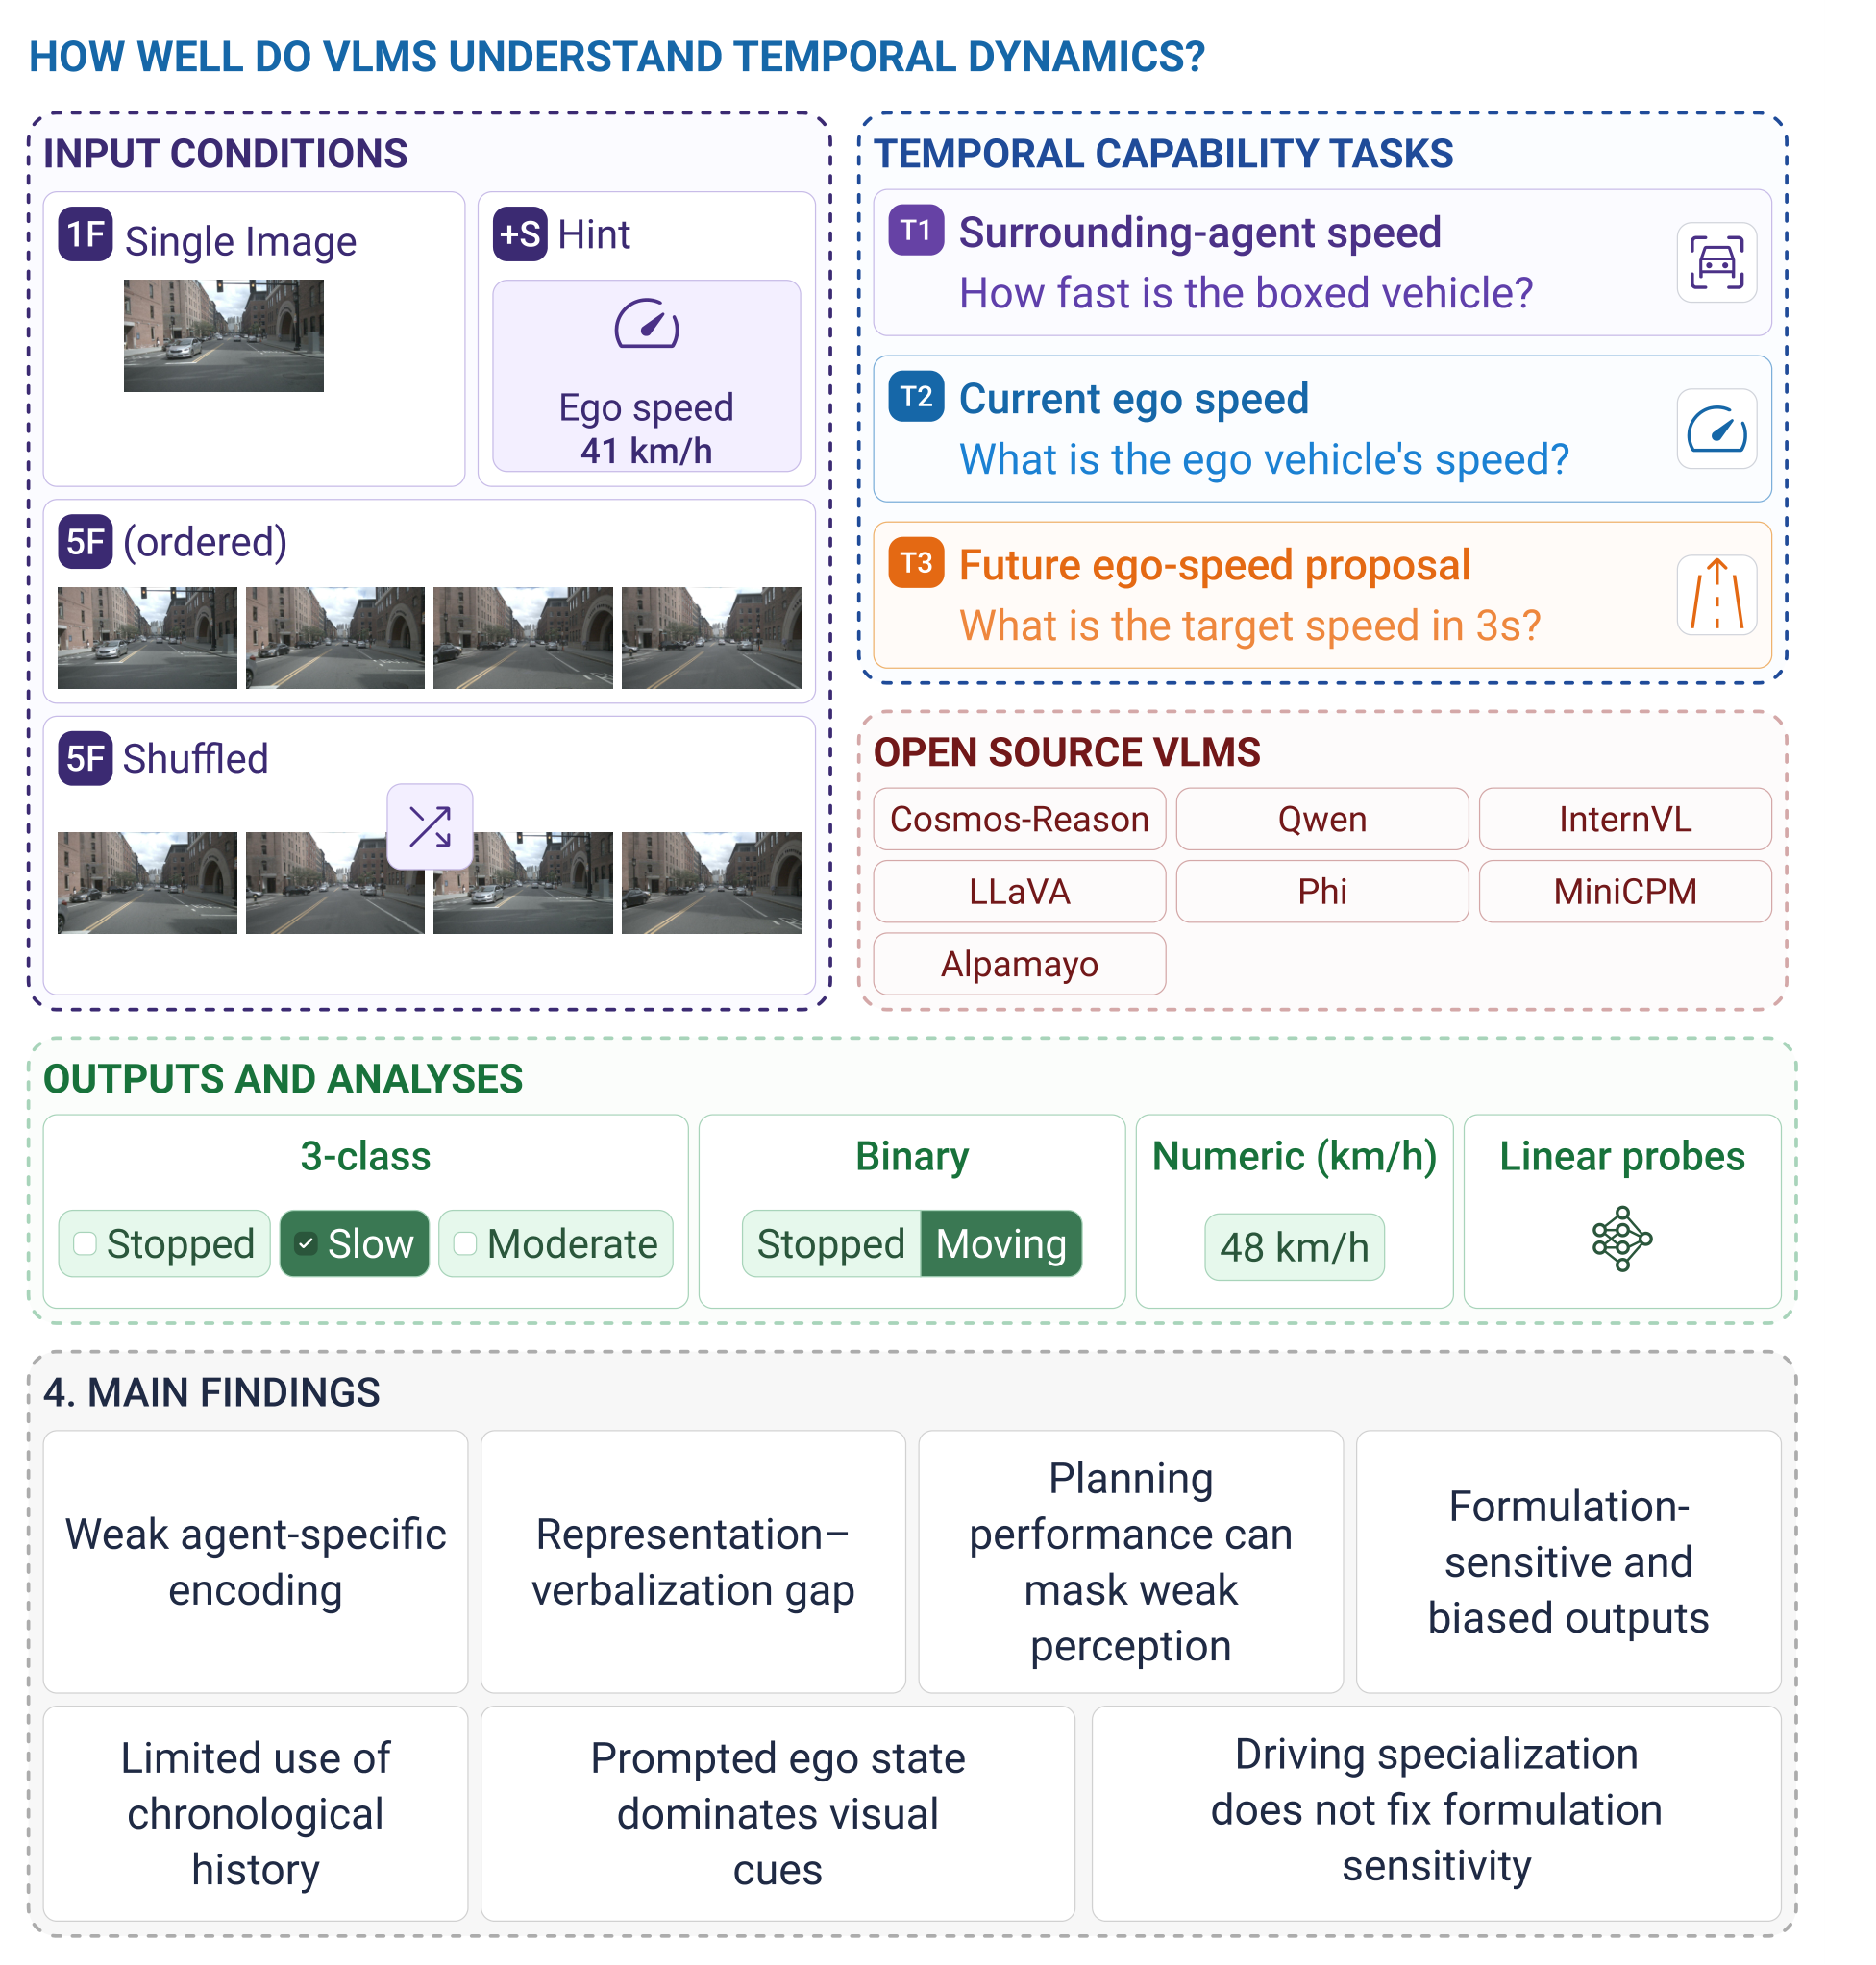
⚡ Speed in the Blind Spot: An Interpretability Analysis of Dynamic Perception in VLMs for Autonomous Driving
动态感知审计:能读出来 ≠ 说得出来 ≠ 时间接地。
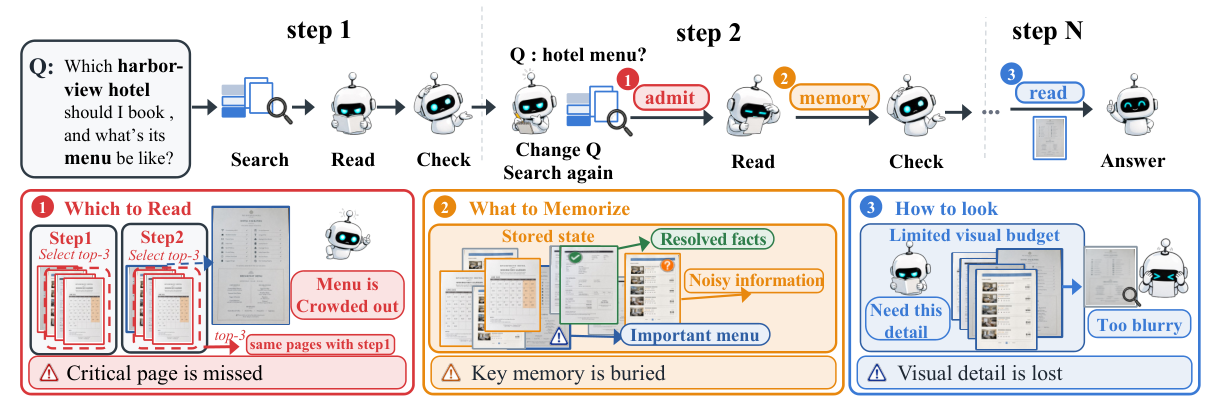
⚡ TAEC: Trajectory-Aware Evidence Coordination for Multi-Step Visual RAG
检索到证据 ≠ 用得上:多步视觉 RAG 的证据生命周期管理。
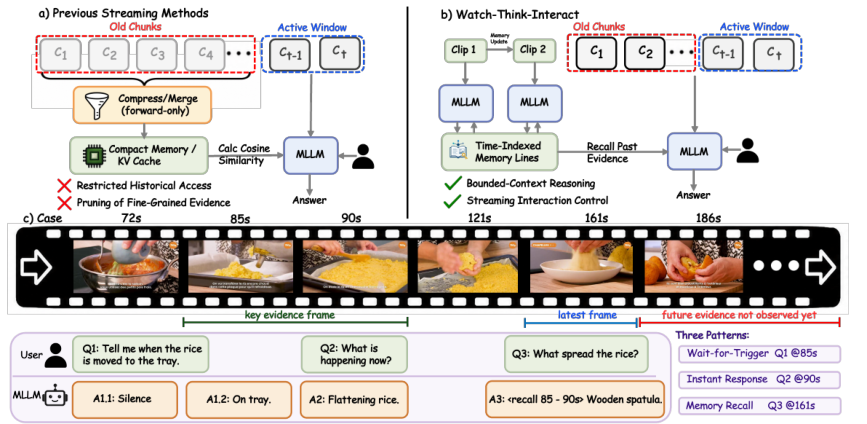
⚡ Watch-Think-Interact: Bootstrapping Long-Horizon Multi-Turn Streaming Video Reasoning with Reinforcement Learning
流式视频多轮推理:看、想、按需回找。
自动生成于 2026-10-01 · 基于 arXiv Daily Digest